Awaria Microsoft 365 zaczęła się w czwartek 12 listopada 2026 roku o 19:26 czasu polskiego i objęła Exchange Online, Teams, SharePoint Online, Microsoft 365 Copilot oraz Microsoft Defender XDR1. W piątkowym oświadczeniu Microsoft podał, że był to problem techniczny niezwiązany z cyberatakiem, a przyczyną incydentu był problem powstały podczas wcześniejszej rozbudowy przepustowości sieci, który ujawnił się po niedawnej zmianie sieciowej2. W piątek o 15:17 kolejki poczty były według Microsoftu znacznie krótsze i zbliżały się do normalnego poziomu, a w oświadczeniu firma dodała, że nadal przywraca usługi pozostałym klientom i regionom2. Organizacja, której spotkania zależą od jednego dostawcy, powinna przed następną awarią rozstrzygnąć, które z nich przełoży bez straty, a dla których uzgodni dozwolony w niej kanał zastępczy.
Microsoft deklaruje, że z aplikacji 365 korzysta ponad 430 milionów osób3. Zgłoszenia o niedostępności usług napłynęły z 74 krajów i terytoriów, a sam Outlook zebrał prawie 140 tysięcy zgłoszeń w serwisie Downdetector, który liczy zgłoszenia użytkowników i nie podaje liczby poszkodowanych3.
Stan opisany w tekście pochodzi z 13 listopada 2026 roku, z godziny 18:18, kiedy relacja ABC7 Chicago podała piątkowe oświadczenie Microsoftu. Godziny podano w czasie polskim: źródła amerykańskie posługują się czasem wschodnim USA, wcześniejszym o sześć godzin, a Anthropic czasem uniwersalnym, wcześniejszym o godzinę. Żadne z cytowanych źródeł nie podaje, że Microsoft zamknął incydent.
Co się stało i kiedy
Pierwszy sygnał dotyczył Teams. Incydent TM1550488 trwał w czwartek od 15:45 do 16:53, opóźniał albo uniemożliwiał wysyłanie wiadomości w Ameryce Północnej i Południowej, a Microsoft przypisał go rywalizacji o zasoby w infrastrukturze i nie podał, czy ma związek z późniejszą awarią1.
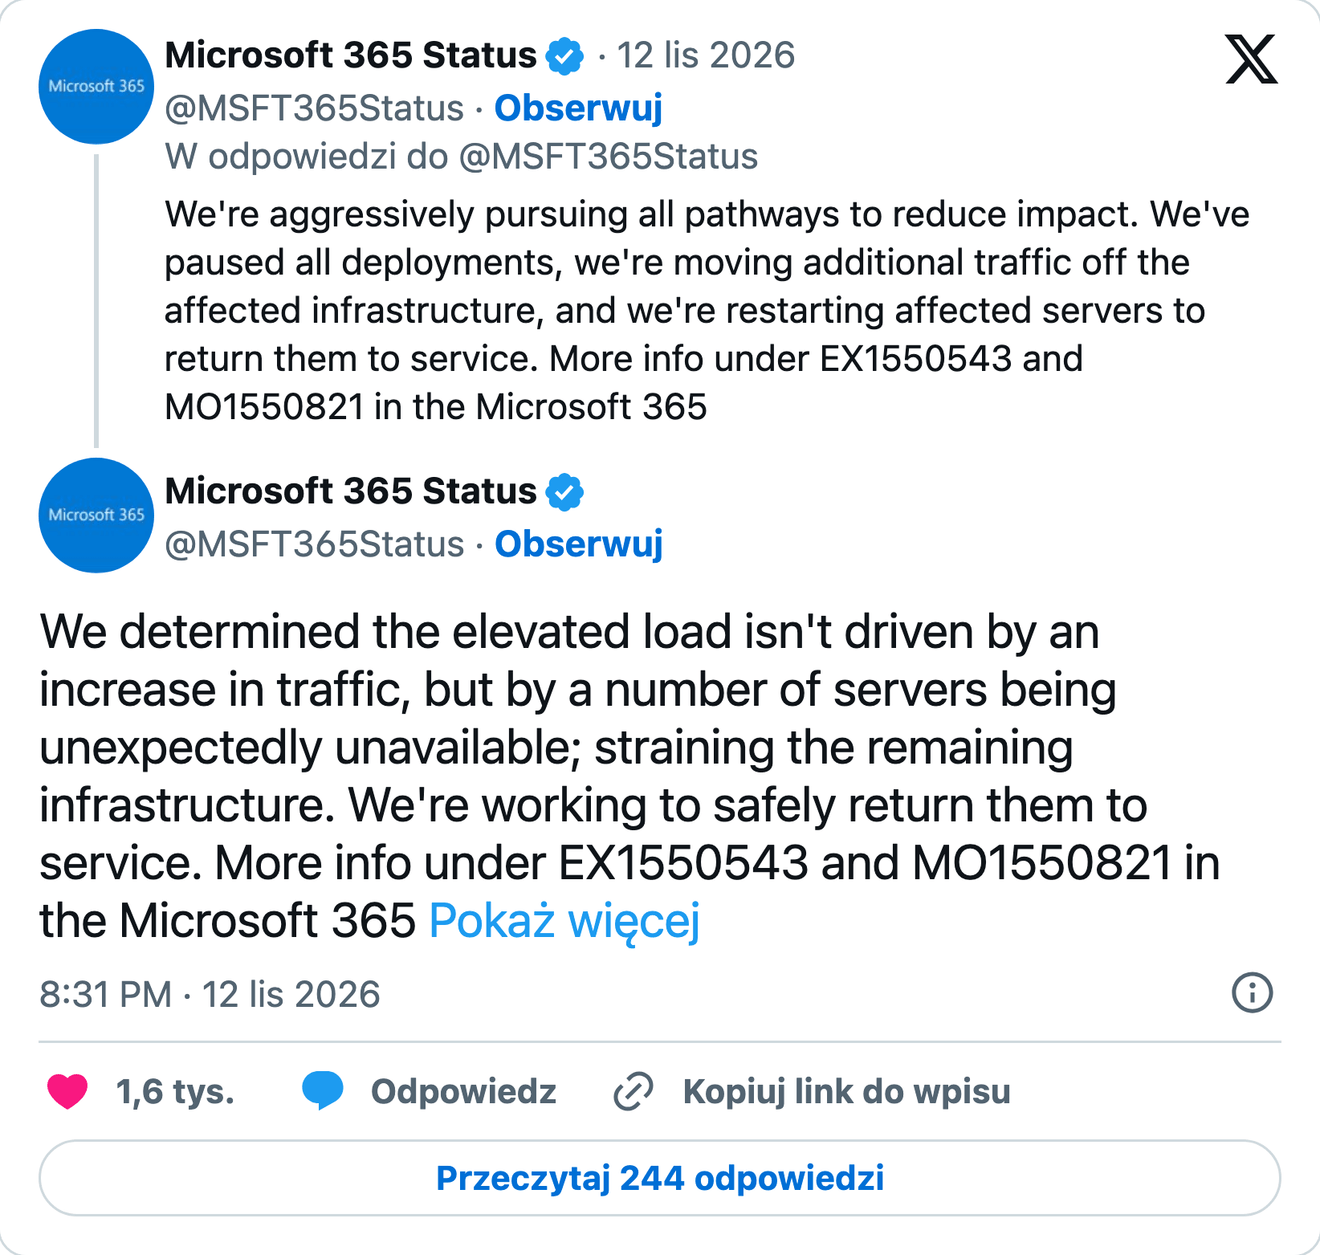
Właściwa awaria, oznaczona w centrum administracyjnym jako MO1550821, zaczęła się o 19:26, choć już wcześniej tego dnia Microsoft badał zgłoszenia o problemach z dostępem do skrzynek Exchange Online w obu Amerykach1. Później potwierdził, że dotknięci mogą być użytkownicy w dowolnym regionie, wstrzymał wszystkie wdrożenia, przekierował ruch połączeń i restartował serwery1.
W piątek o 00:04 Microsoft napisał na X, że przywraca do pracy część serwerów, które jak dotąd pozostają stabilne, i obserwuje ograniczone odzyskiwanie1. Według Euronews serwery przywrócone w nocy przestały działać ponownie, gdy wrócił do nich ruch, a rano Microsoft raportował już tylko nieznaczny postęp34. O 13:09 firma informowała o zachęcających postępach w odzyskiwaniu usług, a o 15:17 o kolejkach poczty znacznie krótszych i bliskich normalnego poziomu, choć część użytkowników mogła nadal napotykać przerywany dostęp2. W oświadczeniu, które relacja ABC7 Chicago podała o 18:18, Microsoft napisał, że obserwuje szeroki powrót i stabilność usług2. Od początku incydentu MO1550821 do chwili, w której relacja ABC7 Chicago podała to oświadczenie, minęły prawie 23 godziny, a firma nadal przywracała wtedy usługi części klientów2.

Które usługi Microsoft 365 przestały działać
Microsoft opisał zakres jako usługi współdziałające z Exchange Online i usługami poczty, a według The Register usługi niewymagające Exchange Online pozostały sprawne5. Lista usług zależy od tego, kto ją podaje.
| Usługi | Kto to podał |
|---|---|
| Exchange Online, Microsoft Teams, SharePoint Online, Microsoft 365 Copilot, Microsoft Defender XDR | Microsoft, komunikat MO15508211 |
| Planner, To Do, Intune, Microsoft Defender for Office 365 | Microsoft, według relacji ABC7 Chicago2 |
| Outlook, Microsoft 365, Azure, OneDrive, Microsoft Store | Zgłoszenia użytkowników w serwisie Downdetector1 |
Poczta docierała z opóźnieniem, a Microsoft wydłużył do 48 godzin czas oczekiwania na opóźnione wiadomości4. Euronews zwraca uwagę, że niedostępny Defender XDR może utrudniać monitorowanie bezpieczeństwa, a użytkownicy powinni sprawdzić, czy ważna wiadomość wysłana w czasie awarii dotarła3. Euronews przypomina też, że oszuści często wykorzystują duże awarie do wysyłania fałszywych wiadomości od pomocy technicznej (phishing), więc każda wiadomość z prośbą o logowanie albo zmianę hasła powinna wzbudzić podejrzenie, a stan usług podaje oficjalna strona statusu Microsoftu3.
Co Microsoft podał o przyczynie
Wyjaśnienie zmieniało się w trakcie awarii. Microsoft najpierw mówił o podwyższonym obciążeniu w wielu regionach, potem o serwerach, które nieoczekiwanie stały się niedostępne i przez to przeciążyły pozostałą infrastrukturę, przy czym ruch nie wzrósł1. Opisywał też problem, przez który serwery nie przechodziły automatycznych kontroli stanu i przestawały być dostępne5, podstawowy proces na serwerach, który się przeciążał i powodował utratę zdolności przetwarzania, oraz niewielką liczbę zmian konfiguracji, których cofnięcie rozważał1. W nocy z czwartku na piątek doprecyzował, że przeciąża się proces odpowiedzialny za nawiązywanie bezpiecznych połączeń, a serwery przestają wtedy obsługiwać żądania2. Przetestowana zmiana konfiguracji nie przynosiła według Euronews oczekiwanego skutku, co Microsoft przyznał3.
Microsoft wskazał jako przyczynę problem powstały podczas wcześniejszej rozbudowy przepustowości sieci. W piątkowym oświadczeniu, przytoczonym w relacji ABC7 Chicago, przeprosił klientów i partnerów i napisał, że był to problem techniczny niezwiązany z cyberatakiem ani ze sztuczną inteligencją i agentami, że przyczyną incydentu był problem powstały podczas wcześniejszej rozbudowy przepustowości sieci, który ujawnił się po niedawnej zmianie sieciowej, że zaradził problemowi leżącemu u podstaw awarii i że dalej przywraca usługi pozostałym klientom i regionom2. Dodał, że ze względu na skalę zapotrzebowania przywracał usługi stopniowo i na każdym etapie sprawdzał ich stabilność, a pełny raport po incydencie przedstawi po zakończeniu przeglądu2.
Brzmienie oświadczeń o cyberataku zmieniało się nad ranem. W piątek o 05:11 Microsoft pisał, że nic nie wskazuje na działania złośliwe, a o 06:46, że nie są mu znane takie działania, które powodowałyby incydent, i The Register odczytał to jako brak całkowitego wykluczenia ataku5. Piątkowe oświadczenie wyklucza go wprost2.
| Kwestia | Stan |
|---|---|
| Cyberatak | Microsoft wyklucza go w piątkowym oświadczeniu2 |
| Przyczyna | Problem powstały podczas rozbudowy przepustowości sieci, ujawniony po zmianie sieciowej, według piątkowego oświadczenia; pełny raport zapowiedziany po zakończeniu przeglądu2 |
| Związek z incydentem Teams TM1550488 | Microsoft nie podał, czy istnieje1 |
| Dlaczego tak wiele serwerów zawiodło jednocześnie | Według Euronews pytanie pozostaje bez odpowiedzi do czasu pełnego raportu Microsoftu3 |
| Dane klientów | Według Euronews nic w wypowiedziach Microsoftu nie wskazuje na ich ujawnienie ani utratę3 |
Kogo dotknęła awaria i jak zareagowała Polska
Zakłócenia objęły administrację, ochronę zdrowia i firmy. Kilka przychodni w Wielkiej Brytanii prosiło pacjentów o telefon w sprawach pilnych, a rząd Singapuru i australijska agencja wywiadowcza poinformowały o skutkach awarii3. W Japonii zastępca głównego sekretarza gabinetu Masanao Ozaki potwierdził, że awaria wpłynęła na rządową infrastrukturę informatyczną4. Według Rzeczpospolitej problemy zgłosiły też uczelnie, banki i sądy4.
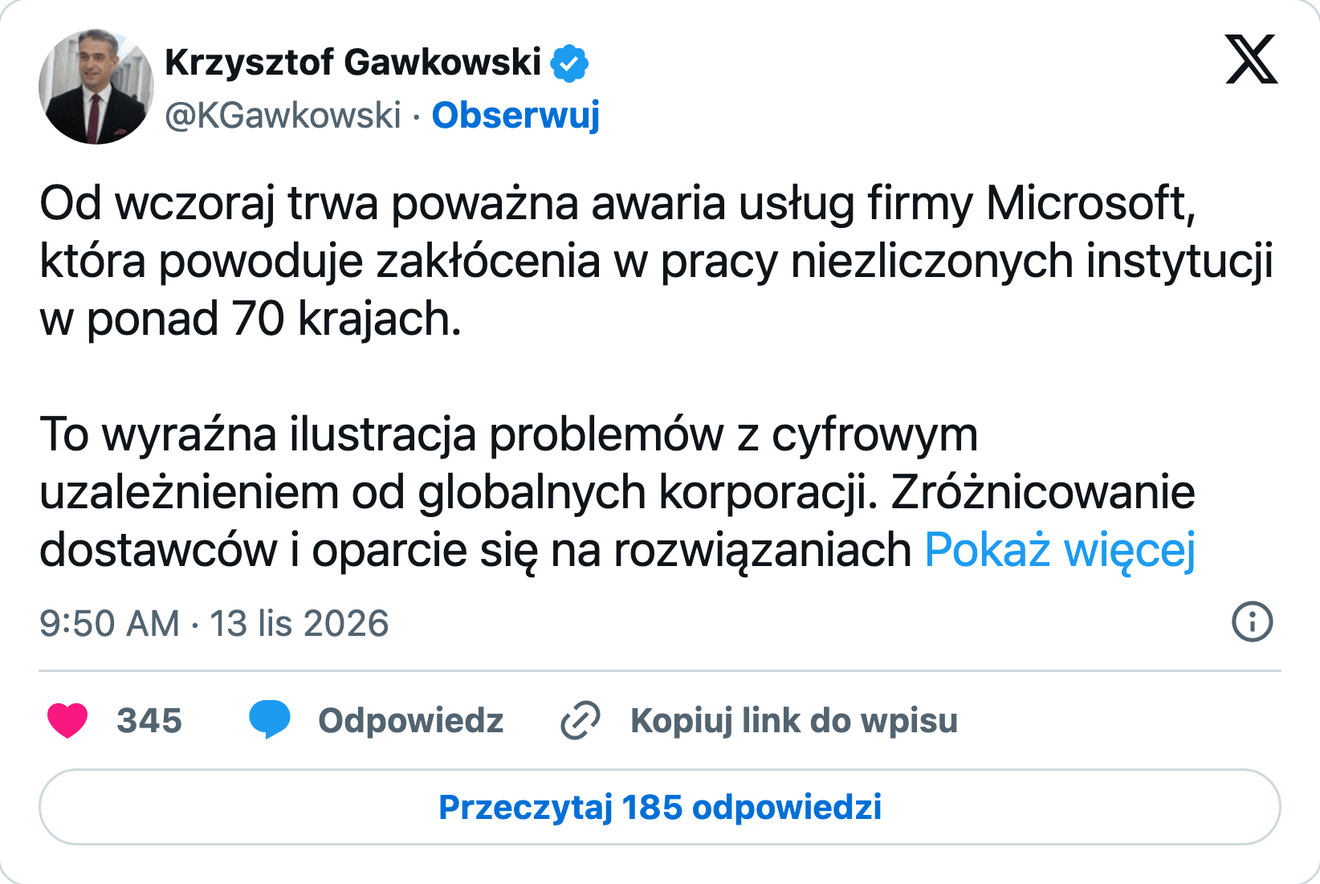
Wicepremier i minister cyfryzacji Krzysztof Gawkowski napisał w piątek o 9:50 na platformie X, że to "wyraźna ilustracja problemów z cyfrowym uzależnieniem od globalnych korporacji"4. Zróżnicowanie dostawców i oparcie się na rozwiązaniach otwartych ogranicza według niego takie ryzyka, a jak dodał, Ministerstwo Cyfryzacji pracuje nad wdrażaniem rozwiązań open source w administracji publicznej i zapowiada konkurs na pilotażowe wdrożenia w jednostkach samorządu terytorialnego4. Żadne z cytowanych źródeł nie wymienia polskiej instytucji wśród poszkodowanych. Dwa dni przed początkiem awarii resort ogłosił cyberatak na ePUAP, po którym skrzynki państwowego systemu były 11 listopada niedostępne, co opisuje artykuł o niedostępności skrzynek ePUAP po wtorkowym ataku.
Anthropic i OpenAI w tych samych dniach
Anthropic sam przypisał incydent swojego łącznika awarii Microsoftu6, a w przypadku OpenAI Euronews opisuje skutek bez przyczyny3.
| Dostawca | Incydent | Czas (CET) | Przyczyna według dostawcy |
|---|---|---|---|
| Microsoft | Teams, TM1550488: opóźnienia i błędy w wysyłaniu wiadomości w Ameryce Północnej i Południowej | czwartek 12.11, 15:45-16:53 | Rywalizacja o zasoby w infrastrukturze1 |
| Microsoft | MO1550821: Exchange Online, Teams, SharePoint Online, Copilot, Defender XDR | od czwartku 12.11, 19:26; w piątek 13.11 o 18:18 przywracanie usług trwało | Problem powstały podczas rozbudowy przepustowości sieci, ujawniony po zmianie sieciowej2 |
| Anthropic | Łącznik Microsoft 365: poczta, kalendarz i wyszukiwanie, także Claude for Outlook | od czwartku 12.11, 18:52; oznaki odzyskiwania w piątek 13.11, 16:40 | Incydent usługi Microsoft 3656 |
| Anthropic | Błędy na claude.ai, w Claude Code i na platform.claude.com, w tym logowanie | piątek 13.11, 10:58-12:58 | Brak podanej przyczyny7 |
| Anthropic | Błędy w claude.ai, API Claude i Claude Code, później także w łącznikach Docs i Sheets, w Claude Security i Claude Managed Agents | piątek 13.11, 14:09-16:38 | Brak podanej przyczyny8 |
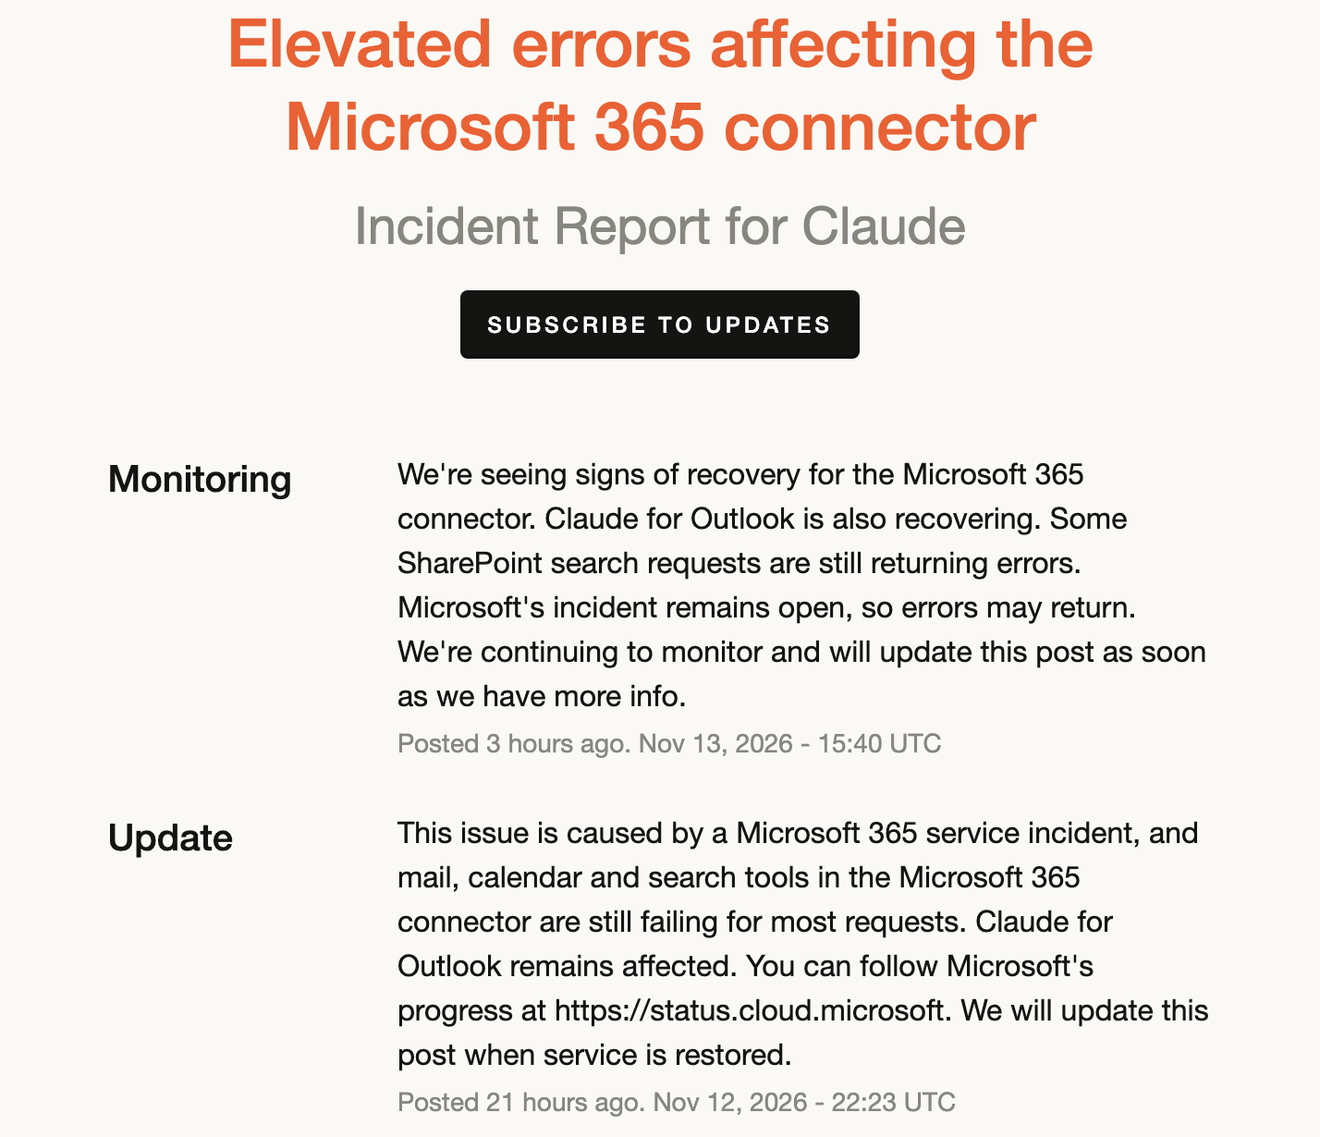
W łączniku Microsoft 365 narzędzia poczty, kalendarza i wyszukiwania zawodziły według Anthropic przy większości żądań, a o 16:40 w piątek firma zastrzegła, że incydent Microsoftu pozostaje otwarty, więc błędy mogą wrócić6. Komunikaty Anthropic o obu incydentach z 13 listopada nie podają przyczyny ani nie wiążą ich z awarią Microsoftu.
Wcześniejsze awarie Microsoft 365 w 2026 roku
W styczniu 2026 roku awaria Microsoft 365 trwała prawie dziesięć godzin: Microsoft potwierdził problemy 22 stycznia o 20:37 czasu polskiego, o 06:33 podał, że przywrócił dostęp, a przyczynę opisał jako część infrastruktury w Ameryce Północnej, która nie przetwarza ruchu zgodnie z oczekiwaniami9. W sierpniu wadliwa aktualizacja kodu zakłócała według Euronews pracę Outlooka i Exchange Online przez kilka dni3. Od początku obecnego incydentu do relacji ABC7 Chicago o oświadczeniu Microsoftu minęło ponad dwa razy więcej czasu, niż trwała styczniowa awaria.
Co ustalić w firmie przed następną awarią
Według The Register użytkownicy Microsoft 365 nie mogli w czasie awarii uczestniczyć w spotkaniach Teams5. Euronews wymienia wśród jej skutków także to, że amerykański producent pojazdów elektrycznych Workhorse przełożył telekonferencję o wynikach finansowych na poniedziałek3.
Dywersyfikacja dostawców, którą wskazuje minister cyfryzacji, wymaga zmiany architektury usług, a organizacja, która zostaje przy jednym dostawcy, nadal może uzgodnić zasady dla spotkań i komunikacji na czas jego awarii. Dawid Ryłko, architekt IT i ekspert cyberbezpieczeństwa, opisuje, jak je rozstrzygnąć:
Zależność od jednego dużego dostawcy ma tę konsekwencję, że jeden incydent odbiera jednocześnie pocztę, kalendarz i komunikator, czyli także kanały, którymi uzgadnia się rozwiązanie zastępcze. Pokazały to spotkania w Teams, w których uczestnicy nie mogli wziąć udziału: zaproszenie, wpis w kalendarzu i odnośnik do spotkania pochodzą od tego samego dostawcy, dlatego zabezpieczenie musi istnieć w innej formie i zostać uzgodnione przed awarią.
Dla każdego rodzaju spotkania organizacja powinna z góry wybrać akceptację albo ograniczenie ryzyka. Spotkanie, które można przełożyć bez straty, przekłada się według zapisanej zasady, a spotkanie, które musi się odbyć, wymaga uzgodnionego wcześniej kanału zastępczego z danymi dostępowymi przechowywanymi poza Microsoft 365. Wybór takiego kanału wymaga rozwagi, ponieważ administracja publiczna i podmioty regulowane podlegają wymogom bezpieczeństwa i umowom powierzenia przetwarzania danych, a przeniesienie poufnej rozmowy do prywatnego komunikatora zamienia problem dostępności w problem poufności. Organizacja, która nie ma zatwierdzonej alternatywy, powinna z góry przyjąć, że spotkanie się nie odbędzie. Decyzję podejmuje właściciel ryzyka i zapisuje ją w planie ciągłości działania.

Ciągłość działania i ryzyko u dostawców są też przedmiotem przepisów, którym część organizacji już podlega. Wśród środków zarządzania ryzykiem z dyrektywy NIS2, które państwa członkowskie mają nałożyć na podmioty kluczowe i ważne, są ciągłość działania i bezpieczeństwo łańcucha dostaw, obejmujące relacje z bezpośrednimi dostawcami i usługodawcami10. Rozporządzenie DORA wymaga od podmiotów finansowych strategii ciągłości działania w zakresie ICT oraz rejestru ustaleń umownych z zewnętrznymi dostawcami usług ICT11. Które firmy oferują wdrożenie tych przepisów, pokazują strony firm wdrażających NIS2 i KSC oraz firm wdrażających DORA, a terminy zbiera kalendarz obowiązków NIS2, KSC, CRA i DORA.
Źródła
- BleepingComputer, "Massive Microsoft 365 outage disrupts Outlook, Teams, Copilot worldwide", Lawrence Abrams, 12.11.2026 - incydenty TM1550488 i MO1550821, komunikaty Microsoftu do aktualizacji z 12.11 o 18:57 czasu wschodniego USA, godziny wpisów na X z ich identyfikatorów (odczyt 13.11.2026)
- ABC7 Chicago, "Microsoft outage live updates: What to know as Outlook, 365 and other apps are being restored", 13.11.2026 - piątkowe oświadczenie Microsoftu o przyczynie, komunikaty o odzyskiwaniu usług, lista usług objętych awarią (odczyt 13.11.2026)
- Euronews, "Microsoft outage explained: what went wrong and is your data at risk?", Simon Ormiston, 13.11.2026 - skala zgłoszeń, poszkodowani, wcześniejsze awarie w 2026 roku (odczyt 13.11.2026)
- Rzeczpospolita, "Microsoft nie może uporać się z awarią. Problemy w 74 krajach, Polska reaguje", 13.11.2026 - wpis ministra Gawkowskiego, okno poczty 48 godzin, Japonia (odczyt 13.11.2026)
- The Register, "Microsoft's massive M365 outage stretches past 20 hours as its fixes keep failing", Simon Sharwood, 13.11.2026 - zakres usług według Microsoftu, zmiany brzmienia oświadczeń o działaniach złośliwych (odczyt 13.11.2026)
- Anthropic, "Elevated errors affecting the Microsoft 365 connector", 12.11.2026 - incydent łącznika Microsoft 365, przypisany przez Anthropic incydentowi usługi Microsoft 365 (odczyt 13.11.2026)
- Anthropic, "Elevated errors on claude.ai, Claude Code, and platform.claude.com", 13.11.2026 - błędy i logowanie, 09:58-11:58 UTC, bez podanej przyczyny (odczyt 13.11.2026)
- Anthropic, "Claude Status - Incident History", 13.11.2026 - incydent "Elevated errors on claude.ai, the Claude API, and Claude Code", 13:09-15:38 UTC, bez podanej przyczyny (odczyt 13.11.2026)
- The Register, "Microsoft 365 outage drags on for nearly 10 hours", Richard Speed, 23.01.2026 - styczniowa awaria, godziny i opis przyczyny podany przez Microsoft (odczyt 13.11.2026)
- Dyrektywa Parlamentu Europejskiego i Rady (UE) 2022/2555 (NIS2), art. 21 ust. 1 oraz ust. 2 lit. c i d (odczyt 13.11.2026)
- Rozporządzenie Parlamentu Europejskiego i Rady (UE) 2022/2554 (DORA), art. 11 ust. 1 oraz art. 28 ust. 3 (odczyt 13.11.2026)