Na liście CERT Polska z około milionem haseł z wycieków1 przeważają hasła krótkie: 53,1% wpisów ma najwyżej 8 znaków, a im wyżej w rankingu, tym krótsze i bardziej przewidywalne: w pierwszej setce 88 wpisów ze 100 ma najwyżej 8 znaków. Imię albo zdrobnienie to w przyjętej definicji 41 ze 100 pierwszych wpisów, ciąg sąsiednich klawiszy 16. Małą i wielką literę, cyfrę i znak specjalny naraz ma tylko 0,1% listy. Udziały opisują wpisy i progi rankingu, nie ludzi, bo lista nie podaje, ile osób wybrało dane hasło.
Jak ludzie wybierają hasła, widać przede wszystkim w wyciekach, bo tylko tam trafiają do publicznego obiegu w liczbach, które da się policzyć. CERT Polska opisał takie wzorce 10 stycznia 2022 roku na przykładzie pięćdziesięciu najczęstszych pozycji i opublikował słownik około miliona haseł1.
Co to za lista i co znaczą jej udziały
Słownik CERT Polska zawiera około miliona haseł ujawnionych w wyciekach, posortowanych malejąco od najczęściej występujących, a każde z nich wystąpiło więcej niż raz1. Plik ma 1 001 240 wierszy o długości od 4 do 40 znaków, a jego suma SHA-256 to 0c18cf603e46f946e863ee5d9c9e6c07e52dc2e947a9f198cad822a35cf989a4. CERT oparł analizę na wyciekach, w tym z polskich serwisów, i opublikował słownik jako polską wersję1. Słownik ukazał się 10 stycznia 2022 roku, więc nie obejmuje późniejszych wycieków.
Lista nie zawiera liczby wystąpień, więc wpis z pozycji 900 000 waży w niej tyle samo co 123456. Udziały opisują zatem wpisy i progi rankingu, nie osoby ani konta. Progi to pierwsza setka, pierwszy tysiąc, pierwsze 10 000 pozycji i cała lista, a zapis "41 ze 100" znaczy, że tyle ze stu pierwszych wpisów jest imieniem albo zdrobnieniem, nie że tyle osób używa imienia.
CERT wskazuje trzy zniekształcenia, których nie da się usunąć. W wielu wyciekach upublicznione są tylko hasła, które udało się złamać, więc najtrudniejszych brakuje, dane obejmują stare i nieaktywne konta, a źródeł z serwisów o wyższych wymaganiach wobec użytkowników jest bardzo mało1. Do tego dochodzi cecha samej listy: trafiły na nią wyłącznie hasła, które w wyciekach wystąpiły więcej niż raz. Opisuje więc to, co się powtarza, a nie wszystkie hasła, jakie ludzie wybierają. Przeszukać ją można w narzędziu CyberKatalogu: lista najpopularniejszych polskich haseł. Prawdziwego hasła nie wpisuje się jednak do żadnej wyszukiwarki, także do tej.
Ponad połowa wpisów ma najwyżej 8 znaków
Najwyżej 8 znaków ma 531 833 z 1 001 240 wpisów, czyli 53,1%, a mniej niż 8 znaków 30,9%. Im wyżej w rankingu, tym wpisy krótsze: w pierwszej setce takich wpisów jest 88, w pierwszym tysiącu 81,6%, w pierwszych 10 000 pozycji 79%. Najczęstsza długość w pierwszej setce to 6 znaków, a w całej liście 8.
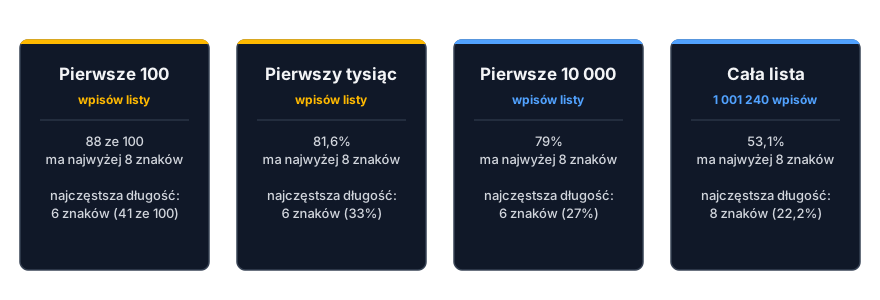
CERT napisał w 2022 roku, że ponad połowa haseł w analizowanych zbiorach z wycieków była nie dłuższa niż 8 znaków. Długość, powołując się na aktualne badania, nazwał głównym czynnikiem siły hasła1. Przeliczenie tej listy potwierdza kierunek, ale mierzy co innego: CERT liczył hasła w zbiorach z wycieków, a 53,1% to udział wpisów listy, w której hasło zajmuje jedną pozycję bez względu na liczbę wystąpień, a najkrótszy wpis ma 4 znaki. Te dwie liczby nie są tą samą miarą.
Słabe hasło to takie, które odgadnie się szybko, a o szybkości decydują długość i przewidywalność. Według obliczeń CERT sprawdzenie wszystkich kombinacji 8 znaków dla bazy 100 000 haseł zabezpieczonych algorytmem SHA1 bez soli kosztuje na wynajętej karcie graficznej około 81 godzin i 324 zł. Słownik miliona haseł przechodzi tę samą bazę w ułamku sekundy1.
Na szczycie rankingu wpisy są krótsze i częściej składają się z imienia albo z sąsiednich klawiszy, a wielkich liter przybywa z każdym progiem:
| Cecha wpisu | Pierwsze 100 (liczba wpisów) | Pierwszy tysiąc | Pierwsze 10 000 | Cała lista |
|---|---|---|---|---|
| Najwyżej 8 znaków | 88 | 81,6% | 79% | 53,1% |
| Co najmniej 12 znaków | 0 | 0,4% | 1,5% | 14,9% |
| Imię lub zdrobnienie | 41 | 38% | 22,7% | co najmniej 6,6% |
| Ciąg sąsiednich klawiszy | 16 | 9,1% | 3,8% | 0,7% |
| Same cyfry | 16 | 5,8% | 4,9% | 7,4% |
| Litery, potem cyfry | 21 | 33% | 40,2% | 38,1% |
| Wielka litera gdziekolwiek | 1 | 1,8% | 4,2% | 7,7% |
| Znak specjalny | 1 | 0,5% | 0,3% | 1,3% |
Imiona i zdrobnienia w pierwszej setce
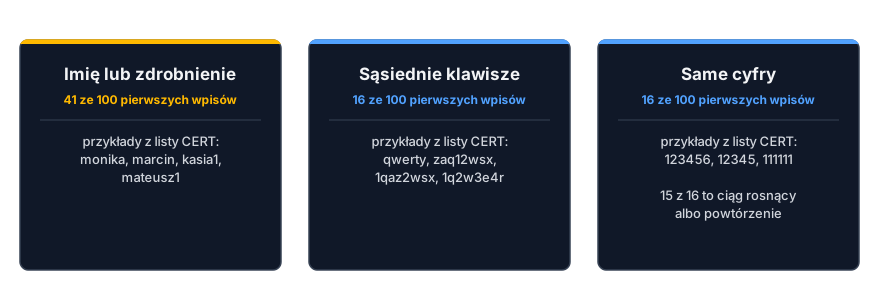
W przyjętej definicji imieniem albo zdrobnieniem jest 41 ze 100 pierwszych wpisów, w pierwszym tysiącu 38%, w pierwszych 10 000 pozycji 22,7%, a w całej liście co najmniej 6,6%, czyli 66 142 wpisy. CERT opisał te hasła jako przede wszystkim imiona lub zwroty osobowe i podał przykłady, wśród nich monika, marcin i kasia11. Przeliczenie pokazuje skalę i to, jak szybko udział maleje wraz z pozycją w rankingu.
Imię liczy się wtedy, gdy po odcięciu końcówki bez liter wpis jest jednym z 782 imion pierwszych z rejestru PESEL, które nosi co najmniej 1000 żyjących osób2. Zdrobnienie to forma oznaczona jako zdrobnienie w hasłach Wikisłownika (licencja CC BY-SA 4.0)3, której nie ma wśród imion z rejestru, na przykład misiek jako zdrobnienie od Michała. Takich form jest 764. Zdrobnień trzeba szukać poza rejestrem, bo prawo zabrania wyboru dla dziecka imienia w formie zdrobniałej (art. 59 ust. 2 ustawy Prawo o aktach stanu cywilnego)4. Większość z nich ma więc w rejestrze mniej nosicieli niż próg.
Granica jest nieostra w obie strony. Wikisłownik uznaje misiek za zdrobnienie od Michała, a lolek od Karola, choć na liście mogą to być zwykłe słowa. Bez wpisów misiek, misiek1 i lolek123 pierwsza setka ma 38 imion i zdrobnień zamiast 41, a bez wszystkich wpisów z rdzeniami misiek i lolek pierwszy tysiąc ma 37,2% zamiast 38%. W drugą stronę Wikisłownik opisuje zdrobnienia tylko przy części imion i pomija na przykład kajtek czy oskarek. Imiona dwuczłonowe i z łącznikiem wypadają z rachunku, więc 6,6% dla całej listy jest szacunkiem z dołu.
Ciągi klawiszy i same cyfry
Ciąg sąsiednich klawiszy to 16 ze 100 pierwszych wpisów, w pierwszym tysiącu 9,1%, a w całej liście 0,7%. Za taki ciąg liczy się wpis z co najmniej jedną literą, zbudowany w całości z sąsiednich klawiszy układu QWERTY. CERT wymienia wśród pięćdziesięciu najczęstszych haseł qwerty, zaq12wsx, 1qaz2wsx i 1q2w3e4r1. W losowej próbie 100 trafień tej kategorii 98 to prawdziwe ciągi klawiszy.
Zaq12wsx i 1qaz2wsx przechodzą po tych samych dwóch kolumnach klawiszy, 1-Q-A-Z i 2-W-S-X, w innej kolejności. Takie hasło łatwo napisać i zapamiętać, a ma małe litery i cyfry, więc spełnia typowe wymagania serwisu.
Same cyfry to również 16 wpisów w pierwszej setce, z czego 15 to ciąg rosnący albo powtórzenie, na przykład 123456 i 111111. Dalej w rankingu pojawiają się daty. Data zapisana sześcioma albo ośmioma cyframi to 3,7% całej listy, czyli 36 738 wpisów. W pierwszej setce nie ma żadnej. Wśród wpisów z samych sześciu cyfr, które nie są powtórzeniem ani ciągiem rosnącym, poprawną datą jest około połowa, a losowy ciąg sześciu cyfr byłby nią w 3% przypadków.
Takie wpisy łamie atak słownikowy (dictionary attack), który sprawdza hasła z gotowej listy zamiast wszystkich możliwych ciągów. CERT zastrzega, że słownik nie gwarantuje odzyskania żadnego hasła, a w praktyce jest bardzo skuteczny i wydajny1.
Jedynka na końcu: jak hasło dopasowuje się do reguł serwisu
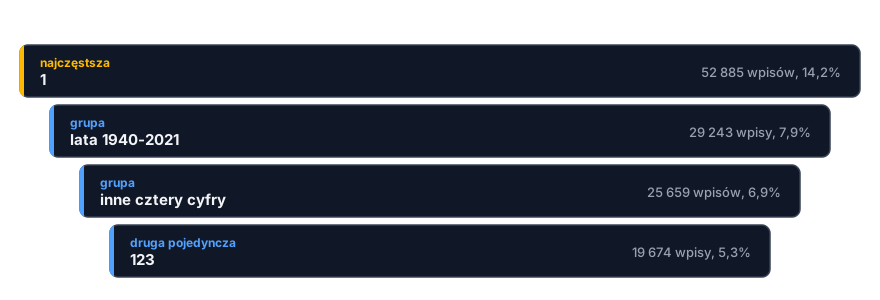
CERT zwrócił uwagę, że hasła takie jak polska1, kasia1 i mateusz1 pokazują, jak użytkownicy próbują wzmocnić hasło albo dostosować je do wymogów dostawcy usługi1. Wśród 371 960 wpisów, które zaczynają się od co najmniej trzech liter, a kończą cyframi, najczęstszą końcówką jest 1: ma ją 52 885 wpisów, czyli 14,2%. Dalej idą grupa lat 1940-2021 (7,9%), grupa pozostałych końcówek czterocyfrowych (6,9%) i 123 (5,3%), a potem 12, 2 i 11; grupy łączą wiele różnych końcówek, a żadna inna pojedyncza końcówka nie przekracza 5,3%.
Dopisana cyfra spełnia wymóg "co najmniej jedna cyfra", ale wzorca nie zmienia. Słowo albo imię zostaje na swoim miejscu, więc słownik uzupełniony o regułę dopisywania cyfr powinien zgadywać takie hasło niewiele wolniej niż samo słowo. Wpisów z literami i cyframi na końcu jest 38,1% listy i 21 ze 100 pierwszych.
Wielkie litery i znaki specjalne prawie nie występują
Wielką literę ma gdziekolwiek 7,7% wpisów, z czego 5% to wpisy, w których wielka jest tylko pierwsza litera, a znak specjalny ma 1,3%. Małą i wielką literę, cyfrę i znak specjalny naraz ma tylko 0,1% listy, czyli 960 wpisów, a polską literę z diakrytykiem 326 wpisów na ponad milion. W pierwszej setce jest po jednym wpisie z wielką literą, ze znakiem specjalnym i z czterema klasami znaków.
To nie dowód, że reguły składu nie działają. Na liście są tylko hasła, które w wyciekach wystąpiły więcej niż raz1, a hasło z czterema klasami znaków powtarza się u różnych użytkowników zapewne rzadziej, więc mogło tu nie trafić. Lista pokazuje tyle, że wśród haseł, które się powtarzają, wielkie litery i znaki specjalne są rzadkie, a wśród dopisanych cyfr przoduje jedynka.
Co z tego wynika dla organizacji
CERT opublikował słownik po to, żeby ułatwić administratorom wdrożenie polityki haseł, bo dla przestępcy przygotowanie takiego słownika jest zadaniem znikomym, a dla administratora niełatwym1. System może odrzucać hasło znane z wycieków w chwili jego ustawiania, zanim trafi do bazy. Takie sprawdzenie odcina hasła, które atakujący może wziąć z tych samych wycieków, a tego reguły składu nie zapewniają. Jak hasła w konkretnej organizacji wypadają na tle takiego słownika, mogą sprawdzić firmy wykonujące testy penetracyjne i audyty.
Minimalna długość 12 znaków odcina wpisy z początku rankingu, ale nie całą listę. Co najmniej 12 znaków ma 0 wpisów z pierwszej setki i 4 z pierwszego tysiąca, a mimo to takie wpisy to 14,9% całej listy. Długość trzeba więc łączyć z odrzucaniem haseł ze słownika. Łatwiej ją osiągnąć zdaniem niż znakami: CERT szacuje, że hasło z pięciu wyrazów jest tak silne jak losowe hasło o 13 do 16 znakach z literami, cyframi i znakami specjalnymi1.
Skradzione albo odgadnięte hasło przestaje wystarczyć, gdy konto chroni uwierzytelnianie wieloskładnikowe. CERT zalicza dwuskładnikowe uwierzytelnienie, obok limitów prób logowania i CAPTCHA, do mechanizmów, które w wielu przypadkach czynią atak online zupełnie nieskutecznym1. Według CERT od wejścia w życie wymagań dyrektywy PSD2 w 2019 roku część usługodawców, przede wszystkim sektor bankowy, musi wymagać dwuskładnikowego uwierzytelnienia przy logowaniu na nieznanym urządzeniu1. Klucze dostępu (passkeys) idą krok dalej, bo zastępują wpisywane hasło parą kluczy kryptograficznych, więc nie ma czego odgadywać ani wyłudzać.
Dopóki hasła są w użyciu, ich wybór przejmuje menedżer haseł, który generuje wartości długie i niepowtarzalne, więc nikt nie musi wymyślać imienia z cyfrą. Unikalność ma znaczenie, bo według CERT atakujący, któremu wyciekło hasło z jednego serwisu, może łatwo ułożyć krótką listę jego wariantów i sprawdzić je w innym, jeśli użytkownik użył tam takiego samego lub podobnego hasła1. Co robić, gdy dane już wyciekły, opisuje przewodnik: co robić po wycieku danych.
Źródła
- CERT Polska, "Co wycieki danych mówią o hasłach", 10.01.2022 - ograniczenia analizy, rozkład długości, pięćdziesiąt najczęstszych haseł, koszty ataków i słownik około miliona haseł (odczyt 07.10.2026)
- Ministerstwo Cyfryzacji, "Lista imion występujących w rejestrze PESEL" - zbiór na dane.gov.pl, imię pierwsze osób żyjących, stan na 24.01.2022 (odczyt 07.10.2026)
- Wikisłownik, "Michał", autorzy haseł - zdrobnienia imion z polskich haseł Wikisłownika (764 formy z wielu haseł, Michał jako przykład), licencja CC BY-SA 4.0 (odczyt 07.10.2026)
- Obwieszczenie Marszałka Sejmu Rzeczypospolitej Polskiej z dnia 12 marca 2026 r. w sprawie ogłoszenia jednolitego tekstu ustawy - Prawo o aktach stanu cywilnego, art. 59 ust. 2 (odczyt 07.10.2026)